
Ochronę przed prompt injection należy projektować tak, aby zmanipulowany model nie mógł samodzielnie rozszerzyć dostępu do danych ani uprawnień narzędzi. To wymaga kontroli w aplikacji i systemach docelowych. Prompt systemowy, klasyfikator treści oraz ocena odpowiedzi pomagają ograniczać ryzyko, lecz nie zastępują autoryzacji.
Ten wpis jest technicznym uzupełnieniem poradnika jak zabezpieczyć firmowego chatbota. Jest przeznaczony dla administratorów, integratorów i osób odbierających wdrożenie. Przedstawione schematy, reguły i scenariusze są propozycją projektową, a nie opisem systemu klienta ani gotową implementacją zabezpieczeń.
1. Model zagrożeń: które treści mogą zmienić zachowanie AI?
Prompt injection to próba wpływania na zachowanie modelu przez instrukcje, które aplikacja powinna traktować jako niezaufane dane. Atak bezpośredni pochodzi z wiadomości użytkownika. Pośredni dociera przez dokument, e-mail, stronę internetową, wynik wyszukiwania lub narzędzia. Instrukcja może znajdować się także w obrazie albo tekście wydobytym przez OCR.
Wspólną cechą jest przekroczenie granicy zaufania: materiał do analizy zaczyna sterować zadaniem. Skutkiem może być zmieniona odpowiedź, ujawnienie informacji lub operacja w połączonym systemie. RAG i dostrajanie modelu nie usuwają tego problemu. OWASP opisuje go jako LLM01:2025. Źródło: OWASP — Prompt Injection.
Przed wyborem zabezpieczeń narysuj przepływ konkretnego procesu. Zaznacz źródła treści, dostępne dane, narzędzia, konta integracji i odbiorców wyników. Dla asystenta ofertowego zapytaj: kto może dostarczyć załącznik, czy model widzi cennik wewnętrzny, czy potrafi zmienić odbiorcę wiadomości i gdzie następuje wysyłka? Taka mapa ujawnia ryzyko dokładniej niż ogólne zapewnienie, że chatbot ma „bezpieczny prompt”.
2. Oddziel instrukcje od treści zewnętrznych
Zaufane reguły aplikacji powinny pochodzić z kontrolowanej konfiguracji. Treści dokumentów zachowują oznaczenie źródła i trafiają do przeznaczonych dla nich pól lub komunikatów. Nie sklejaj załącznika z instrukcją systemową. W dokumentacji Claude treści zewnętrzne są przekazywane jako wyniki narzędzi; szczegóły formatu zależą od używanego interfejsu.
Warto przenosić identyfikator dokumentu, autora, czas pobrania i typ źródła. Poprawna serializacja JSON zapobiega uszkodzeniu struktury danych przez znaki specjalne. Nie sprawia jednak, że model przestaje interpretować znaczenie złośliwego tekstu. Źródło: Anthropic — Mitigate jailbreaks and prompt injections.
Praktyczna reguła dla projektu: dokument może dostarczyć danych do oferty, ale nie może nadać zgody na odczyt dodatkowego zbioru ani zmienić odbiorcy bez kontroli. Wykrycie sformułowania udającego administratora powinno uruchamiać ocenę materiału, nie awansować jego uprawnienia.
3. RAG: kontroluj dostęp przed zbudowaniem kontekstu
W RAG model otrzymuje fragmenty znalezione w bazie wiedzy. Uprawnienia powinny obowiązywać już przy wyszukiwaniu, także dla pojedynczych fragmentów. Metadane kontroli dostępu muszą pochodzić z systemu źródłowego i aplikacji, a nie z treści dokumentu. Rozdzielenie organizacji obejmuje indeksy lub filtry, historię i pamięć podręczną.
Odebranie dostępu powinno unieważniać stare wyniki. Sprawdzanie integralności dokumentu wymaga chronionej wartości odniesienia. Zgodność skrótu SHA-256 potwierdza zgodność z zatwierdzoną wersją, lecz nie dowodzi braku szkodliwych instrukcji. Źródło: OWASP — RAG Security.
Proponowany test: utwórz dwie fikcyjne firmy i dokument zawierający rozpoznawalny znacznik. Wyszukaj go jako użytkownik drugiej firmy. Sprawdź wynik wyszukiwarki, kontekst wysłany do modelu i odpowiedź. Następnie odbierz dostęp prawidłowemu użytkownikowi i powtórz próbę w istniejącej rozmowie. Samo ukrycie cytatu w interfejsie nie wystarcza, jeżeli treść nadal dociera do modelu.
4. Kontrola narzędzi: decyzja o wykonaniu poza modelem
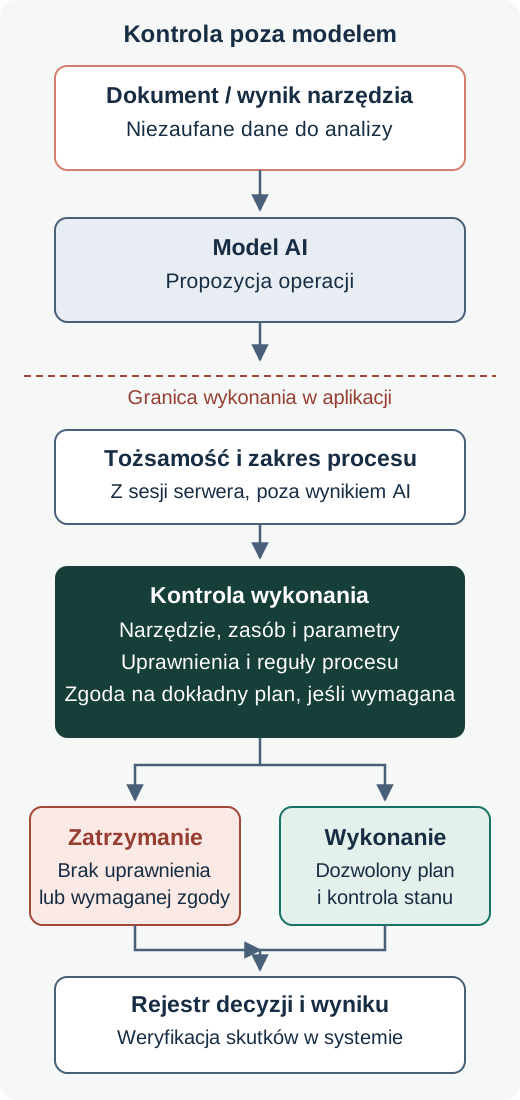
Model powinien proponować operację, a komponent wykonawczy niezależnie ustalać, czy można ją wykonać. Dla każdej propozycji sprawdza tożsamość wywołującego, narzędzie, zasób, parametry i zasady procesu. Brak możliwości ustalenia uprawnienia oznacza zatrzymanie operacji.
Narzędzia powinny odpowiadać wąskim czynnościom. Odczyt zgłoszenia nie wymaga kasowania go; przygotowanie szkicu nie wymaga wysyłki. Unikaj uniwersalnej powłoki lub dowolnego żądania HTTP, gdy wystarczy konkretna funkcja biznesowa. Takie ograniczanie funkcji, uprawnień i autonomii opisuje OWASP LLM06. Źródło: OWASP — Excessive Agency.
Poniższy pseudokod przedstawia proponowaną kolejność kontroli. Nazwy funkcji są opisowe; każda wymaga rzeczywistej implementacji i testów. Schemat nie jest gotowym modułem bezpieczeństwa.
kontekst = tozsamosc_i_proces_z_sesji_serwera()
propozycja = waliduj_schemat(wynik_modelu)
plan = zbuduj_plan_z_dozwolonego_narzedzia(propozycja)

sprawdz_dostep(kontekst, plan.zasoby)
sprawdz_reguly_procesu(kontekst, plan)
sprawdz_odbiorcow_i_zalaczniki(kontekst, plan)

jesli plan.wymaga_zgody:
    sprawdz_zgode_na_dokladny_plan(kontekst, plan)

wykonaj_z_kontrola_aktualnego_stanu(plan)
zapisz_wynik_i_id_operacji()
Tożsamości użytkownika, organizacji ani statusu zgody nie pobieraj z JSON wygenerowanego przez model. Poprawny typ pola nie dowodzi prawdziwości jego wartości. Pole approved: true może być propozycją tekstową; aplikacja musi odczytać stan zgody z własnego, chronionego rejestru.
5. Zgoda człowieka musi dotyczyć konkretnej operacji
Interfejs zatwierdzenia powinien pokazać efekt: adres odbiorcy, treść wiadomości, załączniki, docelowy rekord i zmieniane pola. Ogólne „kontynuuj” utrudnia wykrycie podmiany celu. OWASP zaleca weryfikowanie zgody na dokładną akcję na granicy wykonania. Źródło: OWASP — kontrola human-in-the-loop.
Proponujemy przechowywać zatwierdzony plan jako niezmienny obiekt po stronie serwera: z użytkownikiem, wersją zasobów, terminem ważności i identyfikatorem operacji. Zmiana odbiorcy lub załącznika tworzy nowy plan i wymaga ponownego zatwierdzenia. Przy wykonaniu trzeba porównać aktualny stan zasobów; jeśli zmieniły się dane istotne dla zgody, operacja wraca do oceny.
Uwzględnij ponowienia. Po zerwanym połączeniu status wysyłki może być nieznany. Wtedy sprawdź system docelowy i identyfikator operacji, zamiast automatycznie wysyłać ponownie. Jeśli integracja obsługuje idempotencję, zastosuj ją dla tej samej zatwierdzonej czynności. To ogranicza dodatkowe szkody niezależnie od tego, czy przyczyną była manipulacja, czy zwykła awaria.
6. Ruch wychodzący i renderowanie odpowiedzi
Wyciek może nastąpić przez wynik, nie tylko dedykowane narzędzie wysyłki. Wygenerowany Markdown może wskazywać obraz z zewnętrznego serwera i umieścić dane w adresie. Pobranie takiego zasobu przez przeglądarkę lub serwer staje się osobnym kanałem transmisji. OWASP opisuje ten scenariusz w LLM01. Źródło: OWASP — indirect injection.
W proponowanej architekturze odpowiedź jest renderowana przez kontrolowany komponent: bez aktywnego HTML, z filtrowaniem URL i bez automatycznego ładowania dowolnych obrazów. Linki do dokumentów powstają z identyfikatorów zweryfikowanych po stronie aplikacji. Nie ufaj adresowi wyłącznie dlatego, że model oznaczył go jako źródło.
Dla narzędzia pobierającego adresy potrzebna jest polityka ruchu wychodzącego. Samo sprawdzenie nazwy domeny przed pierwszym żądaniem nie wystarcza. Należy kontrolować przekierowania, rozwiązywanie DNS, adresy prywatne, lokalne i endpointy metadanych oraz dozwolone porty. Rekomendacje MCP obejmują ochronę przed SSRF i DNS rebinding. Źródło: MCP — Security Best Practices.
7. Filtry, klasyfikatory i sandbox: co rzeczywiście zabezpieczają?
Filtr treści może wykrywać próby zmiany instrukcji. Microsoft Prompt Shields rozróżnia ataki w poleceniach użytkownika i materiałach zewnętrznych. W adnotacjach występują osobne stany wykrycia i filtrowania: wykrycie nie jest samo w sobie dowodem blokady. Źródło: Microsoft — Prompt Shields.
Warto klasyfikować także wyniki narzędzi. Drugi model oceniający tekst nadal przetwarza niezaufaną treść; jego werdykt jest sygnałem do polityki aplikacji. Monitoruj błędne alarmy i przeoczenia. Zwykły poradnik bezpieczeństwa może cytować polecenia wyglądające jak atak. Dla awarii klasyfikatora ustal wcześniej zachowanie: np. zatrzymanie wysyłki i pozostawienie projektu do ręcznej oceny.
Sandbox ogranicza środowisko wykonania: pliki, procesy, zasoby i sieć. Jeśli ma szerokie poświadczenia oraz dostęp do Internetu, nadal może umożliwiać niepożądany transfer. MCP zwraca uwagę na ryzyko lokalnych serwerów z dostępem do komputera; sama lokalizacja nie ustanawia bezpiecznej granicy. Źródło: MCP — Local MCP Server Compromise.
| Mechanizm | Co daje | Czego nie potwierdza |
|---|---|---|
| Prompt i opis źródła | Pomagają modelowi rozpoznać rolę materiału | Prawa do danych ani zgody na operację |
| Klasyfikator injection | Dostarcza sygnału o podejrzanej treści | Wykrycia każdego wariantu ataku |
| Schemat JSON | Ogranicza strukturę propozycji | Uprawnienia do wskazanego celu |
| Kontrola dostępu RAG | Ogranicza dane w kontekście | Wiarygodności dostępnego dokumentu |
| Kontrola wykonania | Blokuje akcje poza regułami procesu | Poprawności każdej odpowiedzi modelu |
| Sandbox i polityka sieci | Ograniczają skutki wykonania | Bezpieczeństwa przy nadmiernych uprawnieniach |
Tabela jest syntezą projektową: zabezpieczenia mają różne zadania, dlatego wynik jednego nie powinien być traktowany jako dowód działania wszystkich.
8. Jak testować i mierzyć skuteczność ochrony?
Testuj osobno wpływ na model i skutki w systemie. Model może zaproponować niedozwoloną wysyłkę, którą aplikacja zatrzyma. Może też napisać, że odmówił, mimo wcześniejszego wywołania narzędzia. Potrzebne są ślady całego przebiegu. OWASP zaleca testowanie granic zaufania; poniższe kryteria są naszą propozycją odbioru. Źródło: OWASP — Prompt Injection Prevention.
Używaj fikcyjnych danych, kont testowych i kontrolowanych odbiorców. Rejestruj transmisje do własnego punktu testowego; próby nie powinny powodować wysyłki danych ani zmian w systemach produkcyjnych.
| Próba w środowisku testowym | Oczekiwany wynik | Dowód |
|---|---|---|
| Załącznik żąda dodatkowego odczytu i wysyłki | Brak wykonania poza zakresem procesu | Rejestr decyzji oraz stan systemu docelowego |
| Fragment dokumentu innej organizacji | Brak treści w kontekście i odpowiedzi | Ślad wyszukiwania i wejścia modelu |
| Zmiana odbiorcy po zgodzie | Nowa zgoda albo zatrzymanie | Porównanie zatwierdzonego i wykonywanego planu |
| Odpowiedź z obcym obrazem | Brak automatycznego pobrania | Żądania przeglądarki i serwera |
| Awaria sprawdzania uprawnień | Operacja zatrzymana | Rejestr błędu i brak zmiany danych |
| Zwykły dokument i cytat o atakach | Zadanie działa lub trafia do wyjaśnienia | Ocena użyteczności i błędnych alarmów |
Zapisuj wersję modelu, promptu, narzędzi i zbioru testów. Powtarzaj warianty w kilku uruchomieniach: zmieniaj język, miejsce instrukcji i kanał wejścia, w tym OCR. Raport powinien rozróżniać odsetek zmanipulowanych odpowiedzi, prób niedozwolonych akcji i faktycznie wykonanych akcji. Podaj liczbę prób i zakres zestawu. Wynik „0 wykonanych akcji w 100 próbach” opisuje ten zestaw; nie stanowi obietnicy odporności na każdy przyszły atak.
9. Monitoring i reakcja na incydent
Rejestruj identyfikatory źródeł, proponowanych operacji, decyzji autoryzacji, zgód i wyników wykonania. Treści wrażliwe ograniczaj lub maskuj; pełny materiał dowodowy przechowuj oddzielnie z kontrolą dostępu. Zaplanuj alarm dla powtarzalnych blokad, nietypowych odbiorców i prób użycia narzędzia poza procesem.
Jeśli wystąpił nieoczekiwany skutek, wstrzymaj dotkniętą funkcję i sprawdź logi systemu docelowego. Ustal, co rzeczywiście odczytano, zmieniono lub przekazano. Odtwórz zdarzenie na fikcyjnych danych, popraw właściwą kontrolę i powtórz test regresji. Przypadek, w którym zawiodła autoryzacja, wymaga naprawy autoryzacji. Zmiana promptu może być dodatkowym środkiem. Organizacyjne kroki opisuje plan reagowania na incydent.
10. Od czego rozpocząć wdrożenie?
Wybierz jeden proces i ustal dopuszczalne dane oraz działania. Uruchom najpierw odczyt i tworzenie projektów. Dodanie zapisu lub wysyłki potraktuj jako zmianę zakresu wymagającą oceny uprawnień, zgód i skutków. Odbiór powinien obejmować diagram przepływu, listę narzędzi, matrycę dostępów, raport testów i procedurę wyłączenia funkcji.
Partnerhosted pomaga ustalać zasady bezpiecznego korzystania z AI w firmie oraz porządkować kontrolę dostępów i cyberbezpieczeństwo. Zakres prac dla konkretnej aplikacji i integracji wymaga osobnego uzgodnienia. Do rozmowy przygotuj opis procesu, źródeł danych i operacji, które asystent ma wykonywać.
Najczęstsze pytania
Czy da się całkowicie wyeliminować prompt injection?
Nie należy deklarować pełnej odporności na podstawie promptu, filtra ani ograniczonego testu. Projekt powinien ograniczać wpływ niezaufanej treści oraz blokować niedozwolone skutki niezależnie od odpowiedzi modelu.
Czy poprawny JSON oznacza bezpieczną operację?
Nie. Schemat sprawdza strukturę danych. Aplikacja musi osobno zweryfikować tożsamość, uprawnienia, cel, parametry i ewentualną zgodę na wykonanie.
Czy lokalny model lub MCP usuwa ryzyko?
Nie. Lokalny model nadal analizuje treści, a MCP łączy go z narzędziami. Bezpieczeństwo zależy od danych, uprawnień, izolacji i kontroli operacji w konkretnej konfiguracji.
Jak udowodnić, że atak został zatrzymany?
Sprawdź propozycję modelu, decyzję aplikacji, ruch sieciowy i stan systemu docelowego. Odmowa w rozmowie ani samo wykrycie podejrzanej treści nie potwierdzają braku skutków.
Źródła i zakres opracowania
Źródła sprawdzono 6 października 2026 r. Opracowanie łączy zalecenia źródłowe z autorską propozycją architektury, pseudokodem i scenariuszami odbioru. Przykłady nie opisują incydentów klientów. Nie przeprowadzono tu oceny żadnego konkretnego produktu.
- OWASP LLM01:2025 — Prompt Injection
- OWASP — LLM Prompt Injection Prevention Cheat Sheet
- OWASP — RAG Security Cheat Sheet
- OWASP LLM06:2025 — Excessive Agency
- Anthropic — Mitigate jailbreaks and prompt injections
- Microsoft Learn — Prompt Shields
- Model Context Protocol — Security Best Practices
Ustal zasady bezpiecznej pracy z AI
Opisz proces, źródła danych i połączone narzędzia. Zakres przeglądu konkretnej integracji ustalimy indywidualnie.
Porozmawiaj o zasadach bezpiecznego korzystania z AI