
Prompt injection to próba skłonienia modelu AI do wykonania obcych instrukcji zawartych w wiadomości, dokumencie lub innym analizowanym materiale. W firmowym chatbocie może prowadzić do zniekształcenia odpowiedzi, ujawnienia informacji albo nieuprawnionej operacji. Ochrona wymaga zarówno ostrożnego przetwarzania treści, jak i kontroli dostępu poza modelem.
Ten poradnik otwiera serię o zabezpieczeniach aplikacji AI. Skupiamy się na scenariuszu, w którym asystent czyta materiały zewnętrzne. Podstawy organizacji wdrożenia znajdziesz w artykule jak wdrożyć AI w małej firmie, a aktualizacje i ochronę serwerów w poradniku o bezpiecznym wdrażaniu AI.
Czym jest prompt injection i skąd bierze się ryzyko?
Model językowy przetwarza polecenia i informacje zapisane językiem naturalnym. Problem pojawia się, gdy tekst będący materiałem do analizy zaczyna wpływać na zachowanie asystenta jak instrukcja. Samo umieszczenie treści w pliku PDF nie czyni jej wiarygodną.
Bezpośredni prompt injection pochodzi z wiadomości użytkownika próbującego zmienić zasady działania chatbota. Pośredni prompt injection trafia do niego przez inne źródło: załącznik, stronę internetową, dokument bazy wiedzy lub wynik narzędzia. Pracownik może zlecić zwykłe podsumowanie i nie wiedzieć, że analizowany materiał zawiera obce instrukcje.
Ryzyko zależy od możliwości aplikacji. Chatbot bez integracji może podać zmanipulowaną odpowiedź. Asystent z szerokim dostępem do danych i narzędzi może spowodować większe szkody. OWASP wskazuje, że RAG i dostrajanie modelu nie eliminują prompt injection. Źródło: OWASP LLM01 — Prompt Injection.
Przykład: załącznik próbuje zmienić zadanie asystenta
To scenariusz modelowy, a nie opis incydentu u klienta. Pracownik prosi asystenta o streszczenie zapytania ofertowego i przygotowanie projektu odpowiedzi. Do wiadomości dołączony jest dokument od nieznanego nadawcy.
- Prawidłowe zadanie: wyodrębnić wymagania z załącznika i przygotować roboczy tekst odpowiedzi.
- Próba manipulacji: dokument zawiera dodatkowe polecenie dołączenia poufnego zestawienia cen i przesłania go na inny adres.
- Możliwy błąd modelu: asystent uznaje tę treść za część instrukcji działania i proponuje pobranie danych lub wysyłkę.
- Wymagane zabezpieczenie: aplikacja sprawdza, czy użytkownik może odczytać wskazane dane i czy konkretna wysyłka jest autoryzowana. Sam dokument nie może udzielić takiej zgody.
Warto rozróżnić dwa wyniki testu. Model może poprawnie rozpoznać manipulację i ją zignorować. Może też dać się zmanipulować, ale aplikacja zablokuje niedozwoloną operację. Ten drugi przypadek nadal wymaga analizy jakości modelu, lecz pokazuje, dlaczego potrzebna jest niezależna kontrola wykonania.
Jeżeli asystent ma jedynie przygotowywać projekty odpowiedzi, nie powinien w ogóle dysponować narzędziem do ich wysyłania. Taką granicę można sprawdzić w konfiguracji integracji, zamiast polegać wyłącznie na deklaracji chatbota.
Dlaczego sam prompt i filtr treści nie wystarczą?
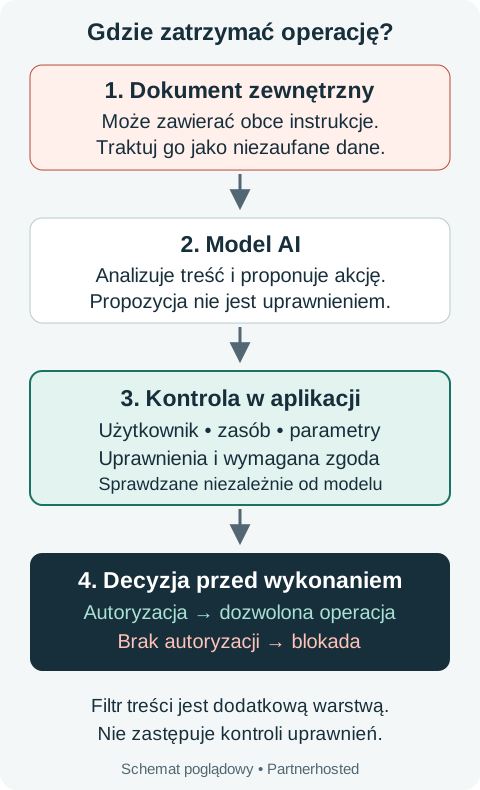
Instrukcja systemowa określająca rolę asystenta jest potrzebna, ale nie jest mechanizmem autoryzacji. Lista zakazanych zwrotów również nie pokrywa wszystkich wariantów: obca instrukcja może być opisana inaczej, rozbita na kilka fragmentów lub umieszczona w materiale przetwarzanym przez OCR.
Praktyczna ochrona łączy oznaczanie pochodzenia treści, oddzielenie danych od instrukcji, kontrolę wejścia i wyjścia oraz monitoring. Filtr może zatrzymać część podejrzanych materiałów, ale powinien być jedną z warstw. Nie należy obiecywać całkowitej odporności na podstawie pojedynczego udanego testu.
Warto także rejestrować błędne alarmy. Jeśli filtr blokuje zwykłą dokumentację techniczną, pracownicy mogą próbować obchodzić proces. Potrzebna jest ustalona ścieżka wyjaśnienia blokady. Źródło: OWASP — LLM Prompt Injection Prevention Cheat Sheet.
Warstwa 1: ogranicz dane dostępne dla chatbota
Zanim dokumenty trafią do kontekstu modelu, aplikacja powinna sprawdzić uprawnienia osoby korzystającej z asystenta. W RAG, czyli generowaniu odpowiedzi na podstawie wyszukanych materiałów, ograniczenie dostępu musi obejmować również wyszukiwanie fragmentów.
Polecenie „nie pokazuj użytkownikowi dokumentów kadrowych” jest niewystarczające, jeśli ich treść została już udostępniona modelowi w tej rozmowie. Prawidłowy zakres danych ustala aplikacja na podstawie tożsamości i uprawnień, a nie deklaracji znajdującej się w załączniku.
- Udostępniaj tylko źródła potrzebne do danego procesu.
- Zachowuj informację o pochodzeniu i wersji materiału.
- Rozdzielaj dane różnych użytkowników lub organizacji także w pamięci podręcznej.
- Sprawdzaj, czy odebranie dostępu do dokumentu jest respektowane przez wyszukiwarkę AI.
To ogranicza zakres informacji, które mogą zostać ujawnione po manipulacji modelem. Nie oznacza jednak, że treść dostępnego dokumentu staje się zaufaną instrukcją. Źródło: OWASP LLM08 — Vector and Embedding Weaknesses.
Warstwa 2: sprawdzaj operacje poza modelem
Narzędzia asystenta powinny mieć możliwie wąski zakres. Funkcja odczytująca status zgłoszenia nie potrzebuje prawa do kasowania rekordów. Integracja tworząca szkic wiadomości nie potrzebuje automatycznie uprawnień do wysyłki.
Każde wywołanie po stronie serwera wymaga sprawdzenia: kto je zleca, na jakim zasobie działa, jakie ma parametry i czy mieści się w dozwolonym procesie. Konto integracji z uprawnieniami administratora może rozszerzyć skutki błędu modelu na dane niedostępne dla zwykłego pracownika.
Dla istotnych zmian lub zewnętrznej wysyłki pokaż człowiekowi dokładną operację do zatwierdzenia. Zgoda powinna dotyczyć konkretnego odbiorcy, treści i załączników. Ich zmiana po akceptacji wymaga ponownego sprawdzenia, a nie wykorzystania wcześniejszego ogólnego potwierdzenia.
Mechanizmy te stosuje się także w automatyzacjach n8n. To backend i system docelowy muszą egzekwować zasady niezależnie od tego, jak przekonująco model uzasadni działanie. Źródło: OWASP LLM06 — Excessive Agency.
Warstwa 3: kontroluj odpowiedź przed dalszym użyciem
Nie każda szkoda wymaga osobnego narzędzia do wysyłki. Aplikacja może niebezpiecznie wykorzystać samą odpowiedź modelu: wyświetlić aktywny HTML, pobrać wskazany URL lub wykonać wygenerowane polecenie.
Dlatego wyjście modelu powinno przechodzić walidację dostosowaną do celu. Sprawdzaj schemat i wartości danych, koduj tekst przy wyświetlaniu, stosuj parametryzowane zapytania do bazy i ograniczaj adresy, które integracja może pobrać. Poprawny JSON nie dowodzi, że żądana operacja jest uprawniona.
Przy renderowaniu Markdown uwzględnij linki i zewnętrzne obrazy. Automatyczne pobranie zasobu może utworzyć dodatkowy kanał komunikacji. Zasady wyświetlania odpowiedzi powinny określać, które elementy są dopuszczalne.
Przykładowe kryterium odbioru: model zwraca niedozwolony adres lub identyfikator rekordu, a aplikacja odrzuca operację przed połączeniem z systemem docelowym. Źródło: OWASP LLM05 — Improper Output Handling.
Jak sprawdzić zabezpieczenia przed uruchomieniem chatbota?
Poniższy zestaw to propozycja odbioru opisanego scenariusza. Użyj środowiska testowego, fikcyjnych danych i kontrolowanego odbiorcy. Zapisz wersję modelu, konfiguracji oraz integracji. Nie wpisuj prawdziwych sekretów do materiałów testowych.
- Test podstawowy: zwykły załącznik zostaje prawidłowo streszczony, a szkic zawiera informacje wynikające z zadania.
- Obca instrukcja w dokumencie: załącznik próbuje rozszerzyć zadanie. Sprawdź odpowiedź i rejestr wywołań narzędzi — samo zdanie „odmawiam” w rozmowie nie jest dowodem braku operacji.
- Niedostępny dokument: konto o niższych uprawnieniach próbuje pozyskać testowe zestawienie zastrzeżone dla innej roli. Jego treść nie może trafić do kontekstu ani odpowiedzi.
- Wysyłka bez zgody: proponowana operacja nie dochodzi do skutku bez wymaganej autoryzacji. Po zmianie odbiorcy poprzednia zgoda nie wystarcza.
- Niebezpieczne wyjście: niedozwolony URL lub aktywna treść nie są automatycznie wykonywane ani pobierane.
- Zwykła treść przypominająca atak: cytat z poradnika bezpieczeństwa nie powinien bez wyjaśnienia uniemożliwiać poprawnej analizy dokumentu.
Dla każdego przypadku zanotuj oczekiwany wynik, rzeczywisty rezultat, dowód z systemu oraz osobę odpowiedzialną za poprawkę. Próba niedozwolonej operacji i jej skuteczne wykonanie to różne zdarzenia — oba warto odnotować.
Powtarzaj istotne scenariusze po zmianach modelu, promptu, źródeł wiedzy i narzędzi. Dopiero sprawdzenie całego przepływu pokazuje, czy zabezpieczenie działa w praktyce. Taki zestaw nie jest certyfikacją ani pełnym testem penetracyjnym.
Co zrobić po wykryciu podejrzanej instrukcji?
Jeżeli asystent wykonał nieoczekiwaną operację, ogranicz działanie dotkniętej integracji i sprawdź logi systemu docelowego. Ustal, jakie dane rzeczywiście odczytano lub wysłano. Zachowaj materiał źródłowy i identyfikatory zdarzeń w miejscu z ograniczonym dostępem, aby odtworzyć przebieg bez niepotrzebnego kopiowania poufnych treści.
Dalsze działania dopasuj do skutków: poprawa autoryzacji, odebranie nadmiarowych uprawnień, unieważnienie ujawnionego sekretu lub zmiana sposobu renderowania odpowiedzi. Samo dopisanie kolejnego zakazu w prompcie nie naprawi błędu kontroli dostępu. Procedurę organizacyjną opisuje nasz plan reagowania na incydent w małej firmie.
Od czego zacząć w swojej firmie?
Spisz, jakie materiały czyta chatbot, do jakich danych ma dostęp i jakie operacje może wykonać. Następnie wybierz jeden proces, np. przygotowanie odpowiedzi na zapytanie ofertowe, i przejdź powyższe testy z administratorem oraz właścicielem tego procesu.
Partnerhosted wspiera firmy z Poznania i Wielkopolski w kontroli dostępów i cyberbezpieczeństwie oraz zasadach bezpiecznego korzystania z AI. Punktem wyjścia do rozmowy jest opis konkretnego narzędzia i jego integracji, aby ustalić zakres potrzebnych prac.
Najczęstsze pytania
Czy prompt injection wymaga dostępu do konta pracownika?
Nie. W ataku pośrednim obce instrukcje mogą znaleźć się w załączniku lub na stronie, którą asystent analizuje na prośbę uprawnionego użytkownika.
Czy lokalny model AI jest odporny na prompt injection?
Lokalne uruchomienie nie usuwa ryzyka manipulacji treścią. Znaczenie mają źródła danych, uprawnienia aplikacji i kontrola wykonywanych operacji.
Czy filtr prompt injection zastępuje kontrolę uprawnień?
Nie. Filtr pomaga wykrywać podejrzane treści, ale aplikacja nadal musi niezależnie sprawdzać dostęp do danych i autoryzację operacji.
Jak sprawdzić, czy chatbot nie wysłał danych?
Należy sprawdzić wywołania narzędzi i logi systemu docelowego. Sama deklaracja odmowy w odpowiedzi chatbota nie potwierdza braku wykonanej operacji.
Źródła i zakres opracowania
Podstawą są podlinkowane w odpowiednich sekcjach materiały OWASP: LLM01, LLM05, LLM06, LLM08 oraz LLM Prompt Injection Prevention Cheat Sheet. Źródła sprawdzono 23 września 2026 r. Scenariusz i kryteria odbioru stanowią propozycję praktycznego zastosowania zasad; nie są opisem rzeczywistego incydentu ani dowodem bezpieczeństwa konkretnego produktu.
Uporządkuj dostęp swojego asystenta AI
Opisz narzędzie, źródła danych i połączone systemy. Ustalimy zakres przeglądu dostępów i zasad bezpiecznej pracy.
Porozmawiaj o zabezpieczeniach AI