
Krótki prompt nie gwarantuje małego zużycia zasobów. Jedno zdanie może uruchomić analizę setek plików, serię wyszukiwań i wiele poprawek. Efektywne korzystanie z ChatGPT zaczyna się od określenia rezultatu, wyboru sposobu pracy oraz przekazania kontekstu, który rzeczywiście pomaga wykonać zadanie.
Ten poradnik jest przeznaczony dla firm, administratorów IT, programistów i użytkowników pracujących z dokumentami. Zasady organizacji pracy są uniwersalne. Informacje o aktualnych nazwach modeli i ofercie OpenAI sprawdzono 1 października 2026 r. Przykłady są modelowe; nie opisują rzeczywistych klientów ani pomiarów oszczędności.
Tokeny, kontekst i limity: różne mechanizmy
Token to jednostka reprezentacji danych przetwarzanych przez model. W tekście może odpowiadać części słowa, znakowi lub innemu fragmentowi zapisu. Liczba słów nie pozwala dokładnie wyznaczyć liczby tokenów: znaczenie mają język, zapis i tokenizer. Przetwarzanie obrazów również wymaga zasobów; rozmiar pliku w megabajtach nie jest miarą liczby tokenów.
Okno kontekstu określa pojemność informacji dostępnych modelowi podczas przetwarzania. Kontekst może obejmować instrukcje, historię, fragmenty dokumentów i wyniki narzędzi. To ograniczenie pojemności, a nie miesięczny budżet pracy. Osiągnięcie dużej pojemności nie oznacza, że warto ją wypełniać.
Limit wiadomości, jeśli obowiązuje w danej funkcji, ogranicza liczbę wiadomości w określonym okresie. Nie jest tym samym co limit tokenów ani pojemność kontekstu. Wiadomość użytkownika nie jest stałą porcją obliczeń: krótkie pytanie i wielogodzinne zadanie agenta mają inną skalę.
Limit wykorzystania konkretnego modelu określa dostęp do tego modelu zgodnie z zasadami produktu i konta. Wyczerpanie dostępu do jednej opcji nie oznacza automatycznie wyczerpania wszystkich funkcji; możliwość użycia innej sprawdź na swoim koncie. W produktach z wykorzystaniem zależnym od zadania podana liczba wiadomości może być szacunkiem, nie sztywnym limitem.
Limity narzędzi i funkcji mogą dotyczyć np. przesyłania plików, generowania obrazów lub researchu. Część funkcji korzysta też ze wspólnej puli wykorzystania. Nie zakładaj, że każde narzędzie ma niezależny, dodatkowy limit. Kredyty, jeśli dotyczą Twojego konta, są jednostką rozliczenia określonego wykorzystania, a nie synonimem tokenów.
W dokumentacji Work i Codex OpenAI wskazuje, że na wykorzystanie wpływają m.in. model, kontekst, reasoning i narzędzia. Nie przeliczaj cen tokenów API na procent limitu abonamentowego. Rozliczenie API i korzystanie w ramach subskrypcji to różne mechanizmy. Bieżące zasady i stan konta sprawdzaj w oficjalnej dokumentacji wykorzystania oraz panelu usage.
Chat, Work czy Codex? Najpierw wybierz sposób pracy
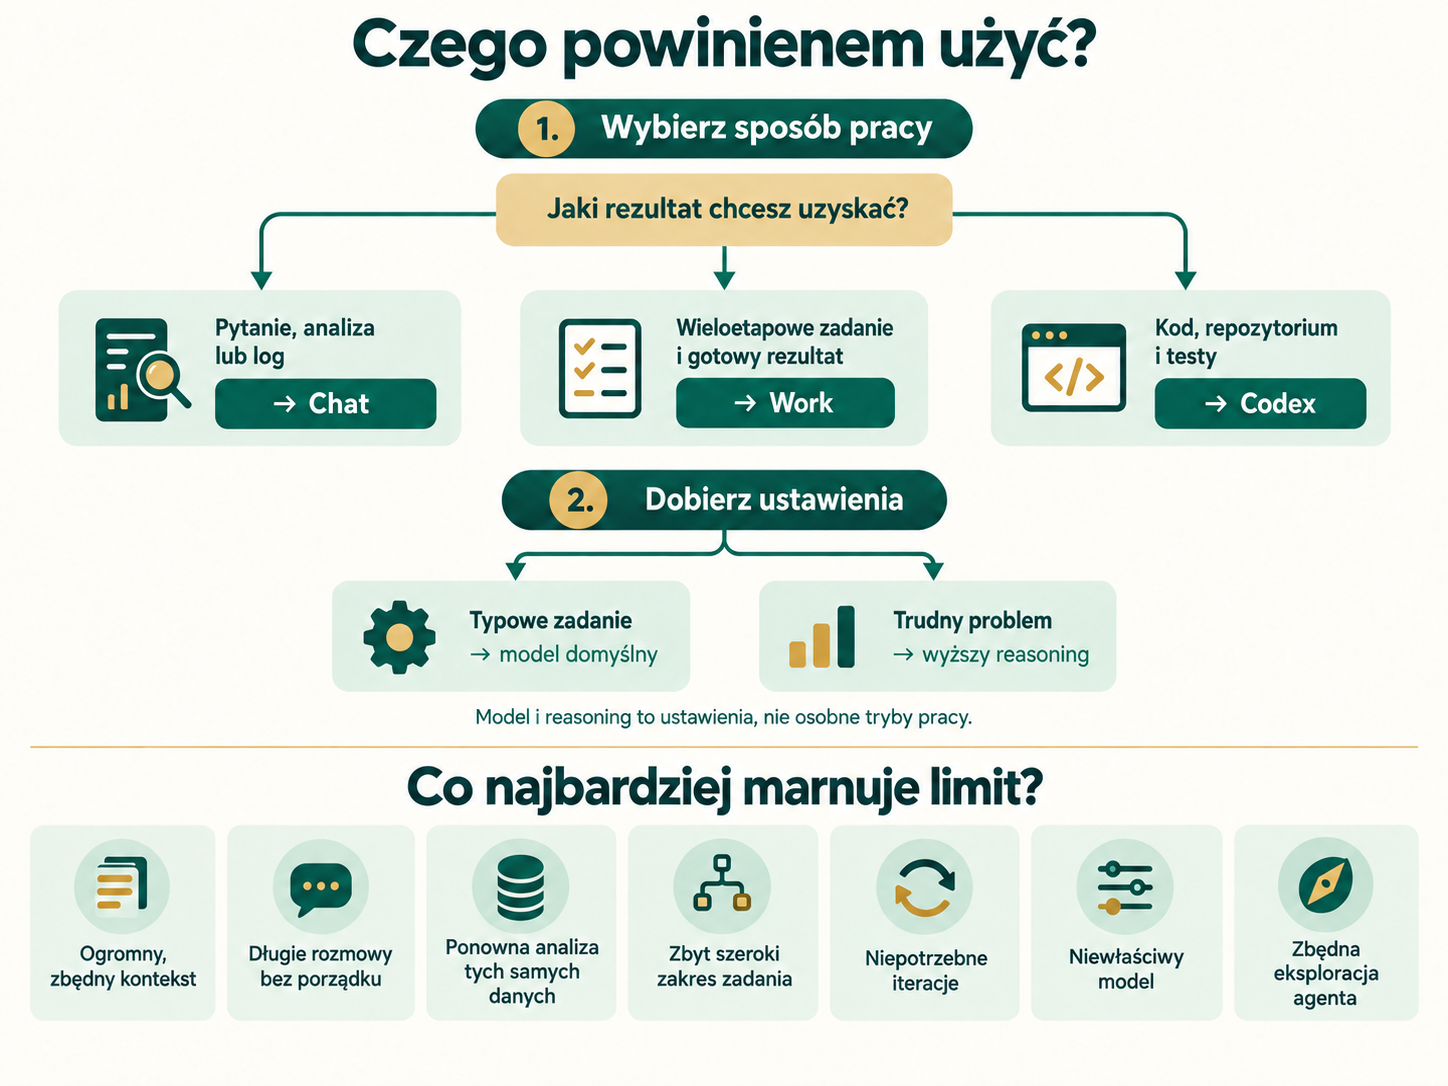
Nie traktuj Chat, modelu Sol, reasoning, Work i Codex jako pięciu równorzędnych narzędzi. Pierwszy wybór dotyczy sposobu pracy; kolejny — dostępnego modelu i jego ustawień.
| Potrzeba | Punkt startowy | Przykładowy rezultat |
|---|---|---|
| Pytanie, interpretacja logu, omówienie konfiguracji | Chat | Wyjaśnienie i wskazanie kolejnego sprawdzenia |
| Rozmowa o raporcie lub porównanie kilku możliwości | Chat | Analiza, argumenty i krótki szkic |
| Zadanie obejmujące kilka źródeł i gotowy plik | Work | Raport, arkusz lub prezentacja do odbioru |
| Zmiana w repozytorium, debugowanie, testy | Codex | Patch, wyniki testów i opis zmiany |
Na małym ekranie przesuń tabelę w bok.
OpenAI opisuje Chat jako pracę przez pytania i rozmowę, Work jako delegowanie zadania zakończonego rezultatem, a Codex jako interfejs z narzędziami i widokami dla programistów. Możliwości Work i Codex częściowo się pokrywają. Dostęp do plików, aplikacji i środowiska zależy od powierzchni produktu oraz uprawnień. Źródło: Use ChatGPT.
Work ma sens, gdy potrzebujesz wykonania pracy, np. porównania ofert i przygotowania arkusza. Samo wyjaśnienie jednej pozycji oferty zwykle nie wymaga zadania agenta. Dokumentacja Work pomaga odróżnić te potrzeby.
Jak dobierać model i poziom reasoning
Model domyślny jest punktem startowym, nie stałą nazwą
Zacznij od ustawienia dostępnego na swoim koncie. Dla powtarzalnej ekstrakcji danych lub klasyfikacji sprawdź lżejszy model, jeśli jest dostępny. Przy niejednoznacznym problemie, sprzecznych źródłach i dużej odpowiedzialności za rezultat porównaj wynik z mocniejszym modelem.
Stan na 01.10.2026: dokumentacja OpenAI opisuje GPT-6.1 Sol jako opcję do złożonej pracy, Lunę do węższych, powtarzalnych zadań, a Astrę do najbardziej wymagających. Modele GPT-6.1 Sol, GPT-6 Sol i GPT-6 Luna są w ChatGPT dostępne w Work i Codex, nie w Chat. Dostępność zależy od konta, klienta, wdrażania i ustawień organizacji. Dlatego „model domyślny” nie oznacza zawsze „Sol”. Źródło: Models.
Większy reasoning powinien rozwiązywać konkretną trudność
Reasoning oznacza pracę modelu nad rozumowaniem. W obsługiwanych konfiguracjach można regulować jej intensywność. Większy wysiłek bywa przydatny przy poszukiwaniu przyczyny awarii, zależnościach między modułami lub ocenie kilku konkurencyjnych hipotez. Nie jest automatycznie potrzebny do poprawienia literówki czy przepisania tabeli.
Dokumentacja API wyjaśnia, że tokeny reasoning są niewidoczne w zwykłej odpowiedzi, lecz zużywają zasoby i są rozliczane jako tokeny wyjścia. Krótka odpowiedź nie musi więc oznaczać krótkiego przetwarzania. To opis API, nie wzór naliczania subskrypcji. Źródło: Reasoning models.
Praktycznie: wykonaj typowe zadanie na ustawieniu domyślnym, oceń zgodność z wymaganiami, a następnie zwiększ reasoning tylko wtedy, gdy brakuje jakości rozumowania. Jeśli brakuje danych wejściowych, najpierw uzupełnij dane. Mocniejszy model nie naprawi nieistniejącego logu ani nieznanej definicji wskaźnika.
Kontekst i długa rozmowa: kiedy zacząć nowy Chat
Historia pomaga zachować decyzje, ale może też mieszać aktualne wymagania z porzuconymi pomysłami. Po kilkunastu poprawkach model musi odróżnić wersję obowiązującą od wersji roboczych. Ryzyko dotyczy zarówno ilości danych, jak i ich niespójności.
Nie zakładaj, że cała historia jest zawsze przekazywana bez zmian. Produkt może wybierać fragmenty, streszczać lub kompaktować kontekst. W API sposób utrzymywania historii zależy od implementacji. Dokumentacja opisuje zarządzanie stanem rozmowy i kontekstem; nie daje uniwersalnego wzoru kosztu dowolnego czatu. Źródło: Conversation state.
Kontynuuj rozmowę, gdy pracujesz nad tym samym rezultatem i wcześniejsze ustalenia pozostają istotne. Rozpocznij nową, gdy zmienia się temat, odbiorca, środowisko albo cel, a stara historia wnosi przede wszystkim szum. Nowy Chat nie resetuje limitu konta i nie gwarantuje niższego wykorzystania.
Przed przeniesieniem zadania przygotuj krótki pakiet: cel, aktualne decyzje, ograniczenia, odsyłacze do źródeł, wykonane sprawdzenia i otwarte pytania. Zachowaj identyfikatory, wersje i daty. Streszczenie bez wskazania dokumentu źródłowego trudno później zweryfikować.
Przykład przekazania: „Przygotowujemy instrukcję backupu dla tej aplikacji. Obowiązuje wersja 3.2. Wybrano wariant B. Test odtworzenia nie został jeszcze wykonany. Korzystaj z pliku procedura-v3.md; następny rezultat to lista kroków testu”. To wystarczająco konkretne, aby nie kopiować całej dyskusji.
Duże logi: najpierw wybierz materiał diagnostyczny
Nie zaczynaj od wklejenia całego miesiąca logów. Podaj system, objaw, czas zdarzenia ze strefą czasową, nazwę usługi i ostatnią zmianę. Wyodrębnij błędy oraz zdarzenia bezpośrednio przed nimi i po nich. Zachowaj kolejność, identyfikatory korelacji i pełne komunikaty.
W środowisku z terminalem najpierw poproś o wyszukanie wskazanego zakresu w pliku. Ogranicz wynik, usuń powtarzalne komunikaty informacyjne, a pełny materiał pozostaw dostępny do sprawdzenia hipotezy. Przy braku dostępu do terminala przygotuj wycinek jako załącznik. Nie usuwaj wszystkich ostrzeżeń tylko dlatego, że nie mają poziomu „error”.
Źle: „Sprawdź serwer i znajdź problem”.
Dobrze: „Na wskazanym serwerze SQL sprawdź dzisiejsze wykonanie zadania nocnej kopii zapasowej w SQL Server Agent. Przeanalizuj błędy związane z nieudanym backupem. Pozostałych instancji nie analizuj, jeśli nie mają związku z awarią. Najpierw wykonaj odczyt; przedstaw dowody i brakujące dane. Nie restartuj usług”.
To zawęża pierwszą analizę, lecz pozostawia drogę do jej rozszerzenia, jeżeli dowody wskażą zależność. W diagnostyce oszczędność nie może oznaczać pominięcia przyczyny poza początkowym wycinkiem. Zasady organizacji kopii opisujemy także w poradniku o backupie dla firm.
PDF, dokumenty i dane: pracuj na pytaniu, nie na rozmiarze pliku
Wskaż rozdział, tabelę i oczekiwany wynik
Przy dużym PDF podaj tytuł, wersję, zakres stron oraz pytanie. Numer strony wydrukowany w dokumencie może różnić się od numeru strony w pliku. Gdy znaczenie ma układ, wykres lub przypis, poproś o sprawdzenie odpowiedniej strony wizualnie. Sam tekst po ekstrakcji może utracić relacje między kolumnami.
Źle: „Przeanalizuj ponownie cały raport i odpowiedz na pytanie dotyczące punktu 8”.
Dobrze: „Na podstawie wcześniej przeanalizowanego raportu sprawdź tylko punkt 8 i jego bezpośredni kontekst. Nie analizuj ponownie pozostałych rozdziałów. Jeżeli wcześniejsza treść nie jest dostępna, odczytaj wskazane strony ze źródła i zaznacz to w odpowiedzi”.
Nie utożsamiaj załączenia dokumentu z każdorazowym wczytaniem całości. Mechanizm zależy od produktu i narzędzia. Dla PDF w obsługiwanym API OpenAI opisuje wykorzystanie tekstu i obrazów stron, co wpływa na zasoby; nie należy przenosić tego mechanizmu wprost na każdą analizę pliku w ChatGPT. Źródło: File inputs.
Obliczenia wykonuj na danych, do modelu przekazuj wnioski i wyjątki
Przy dużym CSV zwykle lepiej policzyć agregaty narzędziem analitycznym niż wkleić wszystkie wiersze do rozmowy. Ustal definicję wskaźnika, zakres czasu, walutę, brakujące wartości i klucz identyfikujący rekord. Następnie poproś o sprawdzenie wyników i opis odchyleń.
Źle: „Przeanalizuj sprzedaż i znajdź ciekawe rzeczy”.
Dobrze: „W pliku sprzedaż.csv porównaj przychód netto za sierpień i wrzesień według działu. Wyklucz anulowane zamówienia. Pokaż zmianę procentową, liczbę rekordów i pięć największych odchyleń. Przy zerowej bazie oznacz zmianę jako nieporównywalną”.
Takie zlecenie ogranicza dowolne poszukiwanie zależności, a wynik można sprawdzić. Nie przesyłaj zbędnych danych osobowych. Więcej o zakresie danych znajdziesz w zasadach ochrony dokumentów firmowych w AI.
Pamięć i wcześniejsze wyniki: unikaj ponownej analizy
Zachowuj zatwierdzone ustalenia w krótkim dokumencie roboczym: mapa źródeł, definicje, wybrany wariant i wynik kontroli. Przy kolejnym pytaniu wskaż, co ma się zmienić. „Sprawdź różnicę między wersją 2 i 3” jest użyteczniejsze niż „przeanalizuj wszystko od początku”.
Pamięć pomaga przywołać wcześniejszy kontekst, lecz nie jest gwarantowanym archiwum pełnego raportu ani mechanizmem bezkosztowego dostępu do wiedzy. OpenAI rozróżnia pamięć ChatGPT w przeglądarce i lokalną pamięć klientów Codex. Reguły zespołu należy zachować w instrukcjach lub dokumentacji projektu. Źródło: Memories.
Nie prosisz o ponowne odczytanie wszystkiego, ale weryfikujesz to, co mogło się zmienić: stan usługi, uprawnienia, cenę, wersję aplikacji. Stare podsumowanie awarii nie dowodzi, że serwer nadal jest w takim samym stanie. Oszczędność dotyczy zbędnej pracy, nie koniecznych sprawdzeń.
W API istnieje także prompt caching: może ograniczać koszt i opóźnienie dla powtarzających się prefiksów przy spełnieniu warunków mechanizmu. To nie to samo co pamięć użytkownika i nie daje uniwersalnej obietnicy oszczędności limitu ChatGPT. Źródło: Prompt caching.
Precyzyjny prompt ogranicza iteracje
Prompt mający 200 słów może zużyć mniej zasobów w całym zadaniu niż jedno niejasne zdanie, jeśli zapobiega szerokiej eksploracji i kilku poprawkom. To zależność warunkowa, a nie reguła „dłuższy prompt jest tańszy”. Zbędne akapity nadal zwiększają kontekst. Oficjalny poradnik Prompting zaleca podawanie istotnego celu, kontekstu, formatu i granic.
Przy większym zadaniu opisz rezultat, źródła, zakres, ograniczenia oraz warunki odbioru. Nie musisz dyktować każdego kliknięcia. Przy prostej zmianie jedno zdanie może być wystarczające. Dopasuj szczegółowość do konsekwencji błędu.
Firma — źle: „Przygotuj strategię AI dla naszej organizacji”.
Dobrze: „Na podstawie tych trzech opisów procesów wybierz dwa zastosowania AI do pilotażu. Porównaj korzyść, wymagane dane i ryzyko. Wynik: tabela oraz rekomendacja na jedną stronę. Nie planuj wdrożenia w pozostałych działach”.
Praca biurowa — źle: „Zrób coś z notatkami ze spotkania”.
Dobrze: „Przygotuj protokół z decyzjami, zadaniami, właścicielami i terminami. Brakujące terminy oznacz jako nieustalone. Zachowaj uzgodnione kwoty. Potrzebuję szkicu do weryfikacji, bez wysyłki”.
Po pierwszej wersji zbierz uwagi w jednym komunikacie. Wskaż fragment, oczekiwaną zmianę i to, co ma zostać. Unikaj kolejnych ogólnych poleceń „popraw”, „rozwiń”, „jeszcze lepiej”, bo każde otwiera interpretację na nowo.
Work i agenci: wyznacz granice samodzielnego działania
Agent może czytać źródła, korzystać z narzędzi, tworzyć pliki i sprawdzać rezultat. Każdy dodatkowy etap może zwiększyć wykorzystanie. Zlecenie „zrób wszystko, co potrzebne” powinno mieć konkretny cel oraz moment zakończenia.
Określ obszar, np. jeden proces, pięciu dostawców albo ostatnie 30 dni. Oddziel wymagany wynik od ulepszeń opcjonalnych. Ustal, czy agent ma wyłącznie odczytywać, przygotować szkic, czy zapisać gotowy plik. Zdefiniuj punkt zatrzymania: po uzyskaniu dowodów, po przygotowaniu materiału lub przed publikacją.
Administrator IT — dodatkowy przykład: „Porównaj konfigurację backupu tych dwóch hostów z załączoną checklistą. Zwróć tylko różnice i brakujące dowody. Nie zmieniaj konfiguracji. Rozszerz analizę wyłącznie, jeśli wykryjesz zależność od innej usługi”.
Wiele agentów bywa przydatnych przy niezależnych analizach, lecz każdy wykonuje własną pracę, a wynik trzeba połączyć. OpenAI wskazuje dodatkowe zużycie tokenów przy subagentach. Równoległość nie jest domyślną metodą oszczędzania. Źródło: Subagents.
Granice kosztu i zakresu warto łączyć z kontrolą uprawnień agentów AI. Ograniczenie przypadkowej eksploracji nie zastępuje kontroli dostępu do systemów.
Codex: ogranicz eksplorację repozytorium i dobierz testy
Codex może pracować na lokalnym repozytorium, zmieniać pliki i uruchamiać dostępne narzędzia. Dokumentacja Codex CLI opisuje te możliwości. Najwięcej niepotrzebnej pracy powstaje wtedy, gdy cel zmiany pozostaje nieokreślony.
Źle: „Przeanalizuj cały projekt i zoptymalizuj”.
Dobrze: „Zmierz czas wykonania build_context(), znajdź trzy najdroższe operacje i przygotuj minimalny patch bez zmiany logiki biznesowej. Uruchom testy dotyczące zmodyfikowanego modułu. Rozszerz weryfikację, jeśli zmiana dotknie wspólnego interfejsu”.
Wskaż moduł, objaw, polecenie odtwarzające problem i kryterium sukcesu. Poproś o sprawdzenie stanu Git przed edycją, zachowanie cudzych zmian i przegląd diffu. Gdy znasz pliki, podaj ich ścieżki. Gdy nie znasz przyczyny, pozwól najpierw wyszukać symbol i bezpośrednie zależności, zamiast żądać czytania wszystkich katalogów.
Drugi przykład programistyczny: „W module eksportu napraw błędną obsługę pustej daty. Odtwórz problem na wskazanym przykładzie. Zachowaj format poprawnych eksportów. Nie zmieniaj stylu kodu w pozostałych modułach. Pokaż patch i wynik testu regresji”.
Testy dobieraj do ryzyka i zależności. Dla lokalnej zmiany zacznij od testu regresji oraz testów modułu. Dla współdzielonego kontraktu, autoryzacji, migracji lub konfiguracji builda może być potrzebna szersza kontrola. Nie ograniczaj jej sztucznie w imię limitu. Po zaliczeniu właściwych sprawdzeń nie uruchamiaj identycznego zestawu ponownie bez powodu.
Kiedy dzielić zadanie, a kiedy zachować ciągłość
Podział pomaga, gdy części mają różne dane, osobne kryteria odbioru i niewielką zależność między sobą. Analizę trzech procesów można zakończyć trzema krótkimi kartami, a potem przygotować porównanie. Ogranicza to mieszanie materiału i ułatwia kontrolę wyniku.
Podział szkodzi, kiedy każda część wymaga ponownego wczytania tych samych źródeł i decyzji. Pięć nowych rozmów o kolejnych zdaniach jednego dokumentu może oznaczać pięć powtórzeń kontekstu. Również koordynacja wielu agentów ma koszt. Dziel według samodzielnych rezultatów, nie mechanicznie według liczby akapitów.
Dobry etap kończy się materiałem do ponownego wykorzystania: zatwierdzonym planem, tabelą ustaleń, patchem albo listą problemów. Kolejny etap powinien odczytywać ten wynik, a nie odtwarzać całą wcześniejszą pracę. Zachowaj źródła potrzebne do sprawdzenia wyjątków.
Wyszukiwanie internetowe: ogranicz zakres, zachowaj aktualność
Wyszukiwanie, otwieranie stron i analiza wyników dodają kroki i materiał do zadania. Są jednak potrzebne, gdy pytanie zależy od bieżących informacji. Dokumentacja Web search opisuje korzystanie ze źródeł oraz zależność dostępności od środowiska.
Źle: „Sprawdź wszystko o nowej wersji systemu”.
Dobrze: „W oficjalnej dokumentacji producenta sprawdź trzy zmiany wpływające na naszą konfigurację. Porównaj wersję 4.1 z 4.2. Podaj źródło, datę i rekomendację dla każdej zmiany. Nie analizuj funkcji konsumenckich”.
Zachowuj tabelę ustaleń z URL, datą i zakresem. Przy pytaniu uzupełniającym wskaż, które źródło ma być sprawdzone ponownie. Nie żądaj kolejnego pełnego researchu, gdy wystarczy odczytać jeden podlinkowany dokument. Przy cenach, limitach, bezpieczeństwie i dostępności produktów potrzebna może być świeża kontrola mimo istniejącej notatki.
Dlaczego optymalizacja limitów staje się ważniejsza?
Aktualność tej sekcji: 01.10.2026. OpenAI ogłosiło 22 września wdrażanie GPT-6 Sol i Luna w Work i Codex, a 29 września — GPT-6.1 Sol. Dokumentacja zapowiada także wycofanie GPT-5.5 z ChatGPT, Work i Codex 14 października 2026 r.; ta zapowiedź nie dotyczy API. Dostępność zależy od planu, klienta i ustawień organizacji. Źródło: oficjalny changelog.
Work i Codex współdzielą wykorzystanie, a wieloetapowe zadania mogą wymagać więcej zasobów niż proste pytania. Dokładne zasady i okresy odnowienia zależą od oferty oraz konta. Nie oznacza to, że każdemu użytkownikowi obniżono limit; przejrzane źródła nie uzasadniają takiego ogólnego stwierdzenia. Źródło: Pricing.
To powód, aby oceniać jakość ukończonego zadania i jego koszt, a nie samą liczbę wysłanych wiadomości. Po zmianie modelu sprawdź kilka swoich typowych zadań; stare ustawienie reasoning nie musi zachowywać się identycznie w nowej generacji.
Codzienny workflow: więcej użytecznej pracy
- Zdefiniuj rezultat. Jedna odpowiedź, tabela, dokument, patch czy gotowy proces?
- Wybierz sposób pracy. Chat do rozmowy; Work do wykonania zadania; Codex do repozytorium i narzędzi programistycznych.
- Przygotuj minimum wystarczających danych. Wybrane logi, strony dokumentu, zakres rekordów i obowiązujące decyzje.
- Zacznij od rozsądnych ustawień. Zwiększ możliwości modelu lub reasoning przy konkretnej trudności.
- Podaj warunki odbioru. Format, zakres, źródła, wymagane sprawdzenia i moment zakończenia.
- Poprawiaj konkretnie. Zbierz uwagi, wskaż fragment i zachowaj zatwierdzone części.
- Zapisz wynik i dowody. Przy kolejnym zadaniu odwołaj się do nich, a informacje zmienne sprawdź ponownie.
Przez tydzień zanotuj rodzaj zadania, ustawienia, czas do poprawnego wyniku, liczbę poprawek i dostępny odczyt wykorzystania. Mierz koszt ukończonej pracy, nie jednego promptu. Panel może obejmować również inne zadania, dlatego sam spadek procentu nie dowodzi kosztu tej jednej operacji. Nie obiecuj zespołowi stałej oszczędności bez porównywalnych pomiarów.
Nie optymalizuj wyłącznie liczby słów w pytaniu. Optymalizuj potrzebny kontekst, liczbę iteracji, dobór modelu i sposób wykonania zadania — przy zachowaniu jakości i koniecznej weryfikacji. To praktyczna zasada, nie gwarancja konkretnej liczby dodatkowych wiadomości.
Partnerhosted pomaga firmom uporządkować praktyczne korzystanie z AI i wdrożenia IT. Dobrym punktem startu jest lista powtarzalnych zadań, używanych źródeł oraz kryteriów poprawnego wyniku.
FAQ: tokeny i limity ChatGPT
Czy krótszy prompt zawsze oszczędza limit?
Nie. Zmniejsza ilość wpisanego tekstu, ale nie musi zmniejszać całej pracy modelu. Niejasne polecenie może wywołać więcej odczytów, wyszukiwań i poprawek. Usuwaj zbędne informacje, zachowując cel, zakres i kryteria wyniku.
Czy nowy Chat resetuje limit konta?
Nie. Nowa rozmowa porządkuje kontekst, lecz nie odnawia limitu wykorzystania. Opłaca się ją rozpocząć, gdy wcześniejszy wątek nie pomaga w nowym zadaniu. Istotne ustalenia trzeba przekazać lub udostępnić w źródłach.
Czy tokeny API odpowiadają limitowi wiadomości ChatGPT?
Nie ma uniwersalnego przelicznika. Tokeny są jednostką przetwarzania, a limity i kredyty podlegają zasadom produktu oraz konta. Ceny API nie służą do obliczania procentu wykorzystania subskrypcji.
Czy Sol jest domyślnym modelem każdego ChatGPT?
Nie. Stan na 01.10.2026: OpenAI udostępnia modele GPT-6.1 Sol i GPT-6 Sol w Work oraz Codex, nie w Chat. Ustawienia domyślne i dostępne modele zależą od konta, aplikacji oraz zasad organizacji.
Czy pamięć pozwala pominąć dokument źródłowy?
Nie przy dokładnej weryfikacji. Pamięć pomaga przywołać ustalenia, ale nie gwarantuje pełnej treści ani aktualności dokumentu. Wskaż wersję i źródło, a przy pytaniu o szczegół sprawdź odpowiedni fragment.
Czy kilku agentów wykona zadanie taniej?
Nie ma takiej gwarancji. Równoległa praca może skrócić czas, ale dodaje pracę poszczególnych agentów i koszt połączenia wyników. Stosuj ją do niezależnych części, które uzasadniają ten narzut.
Czy Work i Codex mają niezależne limity?
Według dokumentacji sprawdzonej 01.10.2026 współdzielą wykorzystanie. Przełączenie sposobu pracy nie tworzy osobnej puli. Bieżące zasady i dostępność funkcji sprawdź w dokumentacji OpenAI oraz na swoim koncie.
Źródła i informacje wymagające aktualizacji
Linki do oficjalnych materiałów OpenAI umieszczono przy odpowiednich zagadnieniach. Sprawdzono je 1 października 2026 r. Wskazówki organizacji pracy i przykłady promptów są propozycjami praktycznego zastosowania, a nie wynikami benchmarku.
Przy aktualizacji poradnika i po zmianach oferty sprawdź ponownie: dostępność modeli w Chat, Work i Codex, nazwy oraz zakres reasoning, wspólne pule wykorzystania, zasady kredytów i odnowienia limitów, możliwości narzędzi oraz terminy wycofania modeli. Te informacje zależą od aktualnej oferty. Reguły ograniczania zbędnego kontekstu, precyzowania zakresu i oceniania poprawnego rezultatu pozostają użyteczne niezależnie od planu.
Uporządkuj korzystanie z AI w firmie
Opisz powtarzalne zadania, używane dokumenty i oczekiwany rezultat. Ustalimy zakres wsparcia i zasady współpracy.
Skontaktuj się z Partnerhosted